| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
- multilingual
- layoutlm
- OCR
- document image understanding
- Text Recognition
- 딥러닝
- document understanding
- Pre-training
- joint training of textual and layout information
- Test set
- layoutxml
- VrDU
- 레이블링
- Today
- Total
JM_Research Blog
[VLA] Octo: An Open-Source Generalist Robot Policy 본문
1. 핵심 의의
1.1 Generalist Policy Pre-training
여러 로봇의 데이터를 함께 사전학습해, 새로운 로봇에서도 처음부터 정책을 만들지 않고 적은 시연 데이터로 빠르게 적응할 수 있는 범용 정책 초기값을 만들었다.
1.2 Modular Input / Output
로봇마다 sensor와 action space가 달라도 pretrained Transformer를 최대한 재사용할 수 있도록 입력 tokenizer와 출력 action head를 모듈식으로 설계했다.
1.3 Diffusion Action Chunk
행동을 이산 token으로 바꾸지 않고 여러 미래의 continuous action을 하나의 chunk로 diffusion 생성해, 여러 가능한 행동 경로와 시간적으로 연결된 움직임을 표현한다.
한 줄 요약: 여러 로봇의 행동 경험을 policy에 미리 학습하고, 새로운 robot·sensor·action space에는 적은 데이터로 빠르게 적응할 수 있게 만든 범용 로봇 정책.
2. Overview
Problem
기존 로봇 정책은 특정 robot embodiment, camera, sensor, action space에 맞춰 학습된다. 따라서 로봇이나 입출력 구조가 달라지면 정책을 다시 설계하거나 학습해야 한다.
RT-X는 여러 로봇 데이터를 함께 학습하면 cross-embodiment transfer가 가능하다는 것을 보여줬다. 하지만 기존 generalist policy 역시 사전학습 당시의 observation과 action space에 강하게 묶여 있어 새로운 로봇 환경에 적응하기 어렵다.
또한 범용 vision encoder는 객체와 장면을 잘 표현하지만, 보이는 상황에서 어떻게 접근하고 grasp하고 움직여야 하는지에 대한 시각-행동 경험까지 직접 제공하지는 않는다.
Octo의 질문: 여러 로봇의 행동 경험을 policy 자체에 미리 학습하고, 새로운 로봇에서는 적은 데이터만으로 빠르게 적응할 수 없을까?
따라서 Octo의 중심은 단순한 zero-shot 성능보다 Generalist Policy Pre-training → Downstream Adaptation에 있다.
Approach
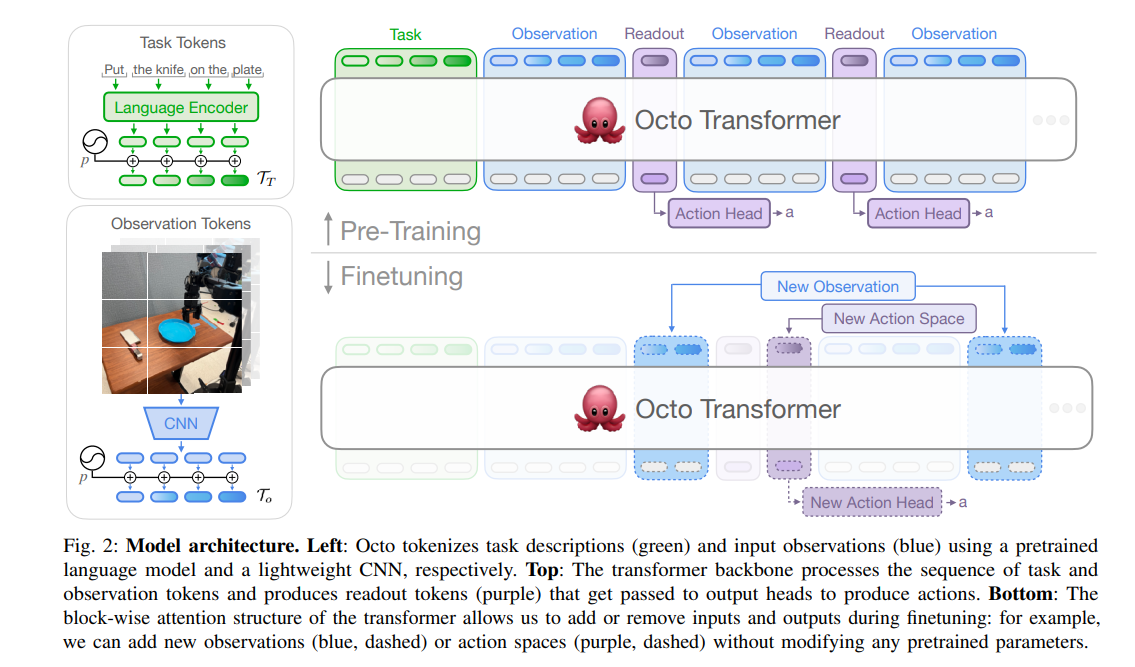
Octo는 image, language, goal image 등의 입력을 token으로 변환해 Transformer에서 처리한다. Transformer의 결과는 readout token을 통해 action head로 전달되고, diffusion head가 여러 미래의 continuous action을 생성한다.
새로운 sensor에는 tokenizer를 추가하고, 새로운 action space에는 action head를 추가한 뒤 전체 policy를 fine-tuning한다.
| 발표 | 2024년 5월 |
| 연구기관 | UC Berkeley, Stanford, CMU, Google DeepMind |
| 모델 | Octo-Small / Octo-Base |
| Parameters | 27M / 93M trainable parameters |
| Backbone | Transformer |
| Language Encoder | Frozen T5-base |
| 학습 데이터 | Open X-Embodiment 25 datasets, ~800K trajectories |
| Input | RGB History (H=2) + Language / Goal Image |
| Output | Continuous Action Chunk |
| 목표 | 새로운 sensor·action space·embodiment에 빠르게 fine-tuning |
| Paper | https://arxiv.org/pdf/2405.12213 |
3. Architecture & Key Ideas
Architecture
| 구성 | 요소내용 |
| Model Type | Multimodal Transformer + Diffusion Policy |
| Parameters | Octo-Small 27M / Octo-Base 93M |
| Input | RGB History (H=2) + Language / Goal Image |
| Vision | Shallow CNN Patch Tokenizer |
| Language | Frozen T5-base |
| Fusion | Block-wise Masked Transformer |
| Output Interface | Readout Token |
| Action Head | MLP Diffusion Head |
| Output | Continuous Action Chunk |
| Pre-training | OXE 25 datasets, ~800K trajectories |
| Fine-tuning | 새 Tokenizer / Action Head 추가 후 Full Fine-tuning |
Language / Goal Image
          +
      RGB History
          ↓
       Tokenizer
          ↓
      Transformer
          ↓
     Readout Token
          ↓
    Diffusion Head
          ↓
Continuous Action Chunk
Octo의 구조는 세 가지 핵심 의의와 대응한다.
| 핵심 의의 | 구현 |
| Generalist Policy Pre-training | Multi-Robot Policy Pre-training |
| Modular Input / Output | Tokenizer + Readout + Action Head |
| Diffusion Action Chunk | Continuous Action Chunk + Diffusion |
3.1 Modular Input / Output
Octo는 입력 처리–Transformer–출력 처리를 분리해 새로운 sensor나 action space가 생겨도 pretrained backbone을 최대한 재사용할 수 있게 했다.
Input
  ↓
Tokenizer
  ↓
Transformer
  ↓
Readout
  ↓
Action Head
  ↓
Action
Input
각 입력은 tokenizer를 통해 Transformer가 받을 수 있는 token으로 변환된다.
Camera / Language / New Sensor
             ↓
          Tokenizer
             ↓
         Transformer
새로운 sensor가 추가되면 해당 sensor용 tokenizer를 추가하고 fine-tuning한다.
Readout & Output
Readout token은 Transformer가 처리한 task·observation 정보를 Action Head가 사용할 출력 representation으로 모으는 인터페이스다.
Transformer Tokens
        ↓
     Readout
        ↓
   Action Head
        ↓
      Action
Readout이 Transformer와 Action Head 사이의 연결 형식을 일정하게 유지해, 입력이나 출력이 바뀌어도 각 모듈을 독립적으로 바꾸기 쉽다.
새로운 action space에서는 다음처럼 새 head를 붙인다.
Pretrained Transformer
        ↓
      Readout
        ↓
  New Action Head
        ↓
 New Action Space
핵심: 새 Sensor → Tokenizer 추가 / 새 Action Space → Action Head 변경 / Transformer는 최대한 재사용.
Pseudocode
task_tokens = language_encoder(instruction)
image_tokens = image_tokenizer(image)

# optional
sensor_tokens = sensor_tokenizer(sensor)

tokens = concat(
    task_tokens,
    image_tokens,
    sensor_tokens,
    readout_token,
)

hidden = transformer(tokens)

readout = hidden[READOUT_POSITION]
action = action_head(readout)
3.2 Diffusion Action Chunk
Action Chunk
일반적인 policy는 한 시점의 action을 예측한다.
State_t
   ↓
Action_t
Octo는 대신 여러 미래 action을 한 번에 예측한다.
State_t
   ↓
[a_t, a_t+1, a_t+2, ...]
여러 action을 함께 예측하면 접근 → 정렬 → Grasp처럼 시간적으로 연결된 행동 관계를 함께 모델링할 수 있다.
왜 Diffusion인가?
같은 상황에서도 성공 가능한 행동 경로가 여러 개일 수 있다.
왼쪽에서 접근 → Grasp
오른쪽에서 접근 → Grasp
단순 MSE regression은 여러 정답 행동이 존재할 때 평균적인 action을 예측하는 경향이 있다.
A = -1
B = +1

MSE → 0
반면 diffusion은 여러 가능한 continuous action 분포를 학습하고, 그중 하나의 action sequence를 생성할 수 있다.
Random Action Noise
        ↓
    Denoising
        ↓
Continuous Action Chunk
Transformer와 Diffusion의 역할
Transformer는 현재 상황과 task를 처리하고, Diffusion Head는 Readout을 조건으로 noisy action을 반복적으로 보정한다.
Image + Language
       ↓
   Transformer
       ↓
    Readout
       +
Noisy Action Chunk
       ↓
 Diffusion Head
       ↓
   Denoising
       ↓
Continuous Action Chunk
큰 Transformer는 action prediction당 한 번만 실행하고, 반복 denoising은 작은 diffusion head에서 수행한다.
readout = transformer(tokens)[READOUT_POSITION]

actions = random_noise(
    shape=(action_horizon, action_dim)
)

for step in diffusion_steps:
    noise = diffusion_head(
        readout,
        actions,
        step
    )
    actions = remove_noise(actions, noise)

return actions
핵심: Action Chunk는 여러 미래 action을 함께 예측하고, Diffusion은 여러 가능한 행동 경로를 하나의 평균값으로 압축하지 않고 분포로 표현한다.
3.3 Training Strategy
Octo의 학습 전략은 Multi-Robot Pre-training → Small-data Fine-tuning으로 정리할 수 있다.
Open X-Embodiment
25 datasets / ~800K trajectories
        ↓
Multi-Robot Policy Pre-training
        ↓
Pretrained Octo
        ↓
~100 demonstrations
        ↓
Full Fine-tuning
        ↓
New Robot / Sensor / Action Space
Multi-Robot Pre-training
서로 다른 robot, task, camera의 데이터를 함께 학습해 시각 정보뿐 아니라 행동 경험까지 포함한 policy 자체를 사전학습한다.
Small-data Fine-tuning
새로운 robot에서는 pretrained Octo를 초기값으로 사용해 약 100개 수준의 demonstration으로 전체 policy를 fine-tuning한다.
New Sensor       → New Tokenizer
New Action Space → New Action Head
보조 학습 기법
- Goal Hindsight Relabeling: 미래 observation을 goal image로 사용해 language annotation이 없는 데이터도 활용
- Modality Dropout: 일부 task modality를 제거해 다양한 입력 조건에 대응
- Dataset Mixture: dataset 크기와 다양성을 고려해 sampling weight 조정
4. Experiments / Evaluation
실험 구성 요약
1. Generalization
- 평가 목적: 사전학습된 Octo가 추가 fine-tuning 없이 여러 robot과 새로운 조건에서도 정책을 재사용할 수 있는지 검증
- 핵심 메시지: 기존 skill의 variation에는 일정 수준 일반화하지만, 새로운 physical skill의 zero-shot 수행 능력은 제한적이다.
2. Adaptation
- 평가 목적: 새로운 sensor, action space, embodiment에서 소량의 demonstration만으로 얼마나 효율적으로 적응하는지 검증
- 핵심 메시지: Octo의 강점은 universal zero-shot보다 재사용 가능한 policy initialization에 있으며, policy pre-training이 downstream adaptation에 효과적이다.
3. Ablation
- 평가 목적: Diffusion action modeling, 데이터 다양성, Transformer 중심 구조가 실제 성능 향상에 기여하는지 분석
- 핵심 메시지: Octo의 성능은 단일 요소보다 Diffusion Action + Data Diversity + Transformer-first Architecture의 조합에서 나온다.
4.1 Generalization
평가 목적
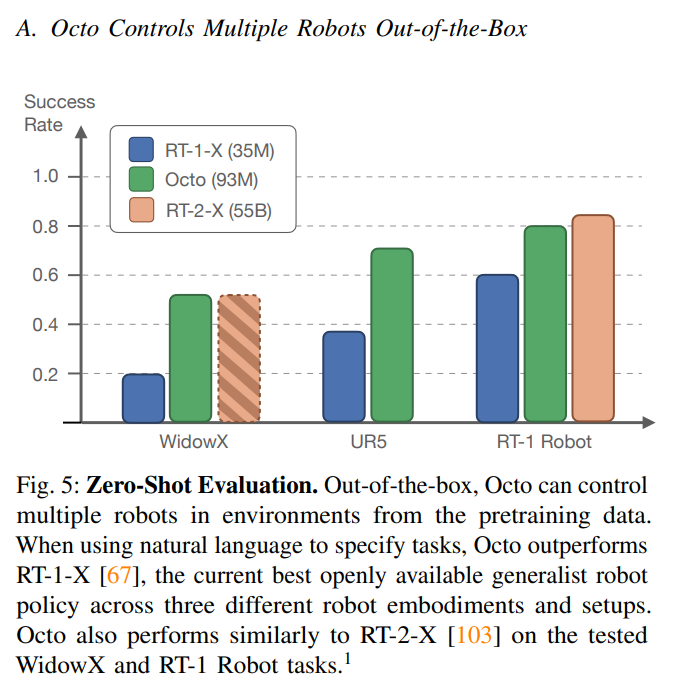
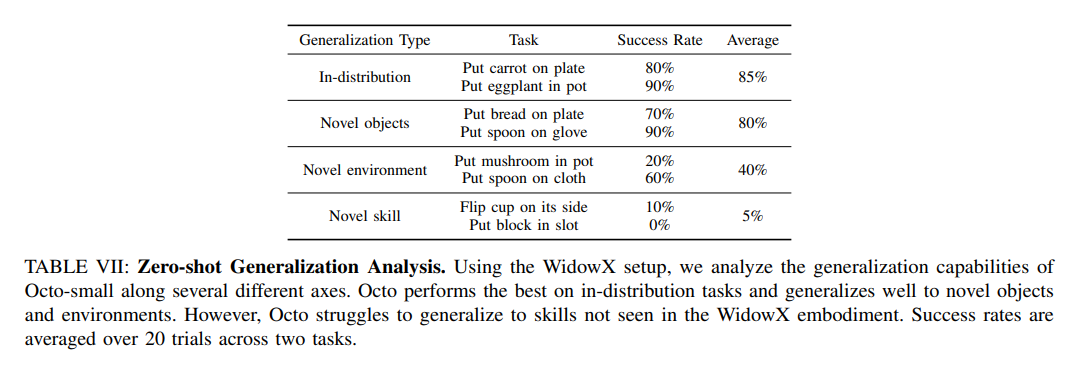
사전학습된 Octo가 추가 학습 없이 여러 실제 robot에서 작동하고, object·environment·skill 변화에도 대응할 수 있는지 검증한다.
핵심 결과 및 해석
- WidowX, UR5, RT-1 Robot에서 RT-1-X보다 평균 29%p 높은 성공률을 기록했다.
- WidowX와 RT-1 Robot에서는 55B RT-2-X와 유사한 수준의 성능을 보였다.
- Novel Object에는 강했지만, Novel Environment와 Novel Skill에서는 성능이 크게 떨어졌다.
- Octo는 새로운 skill을 만드는 zero-shot 능력보다, 학습한 skill을 다양한 조건에 재사용하는 generalization에 강하다.
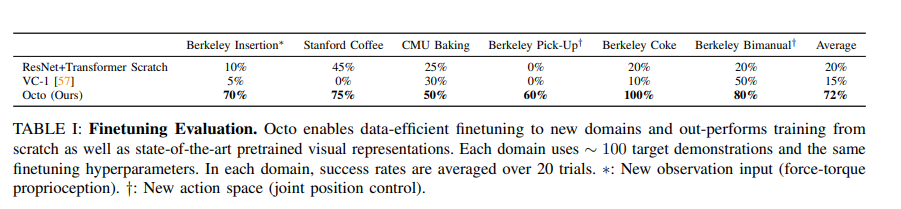
4.2 Adaptation
평가 목적
새로운 sensor, action space, embodiment에서 pretrained Octo가 약 100개 demonstration만으로 빠르게 적응할 수 있는지 검증한다.
핵심 결과 및 해석
- 약 100개 demonstration으로 평균 **72%**를 기록해 Scratch 20%, VC-1 15%를 크게 앞섰다.
- → 단순 visual pre-training보다 시각과 행동이 연결된 policy 전체를 사전학습하는 것이 downstream adaptation에 더 효과적이다.
- → 새로운 sensor와 action space에도 적응해 Modular Input / Output 설계의 실효성을 보여준다.
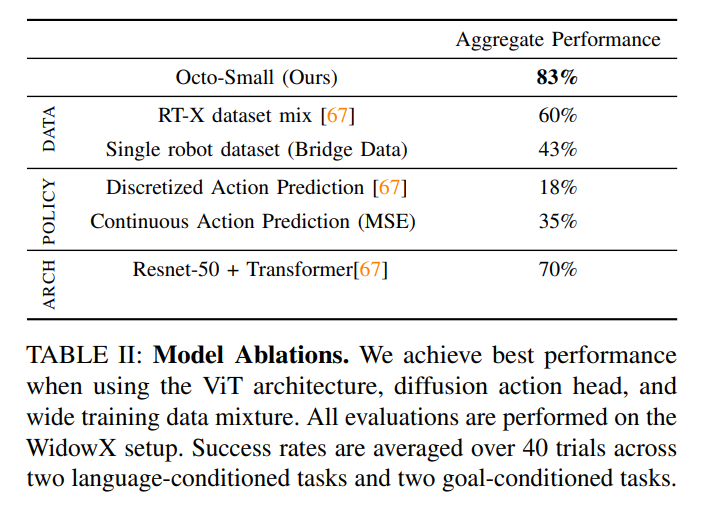
4.3 Ablation
평가 목적
Action representation, 데이터 구성, architecture 같은 설계 선택이 실제 성능 향상에 기여하는지 분석한다.
핵심 결과 및 해석
- Action Modeling: Diffusion 83% > MSE 35% > Discrete 18%
→ 여러 가능한 continuous action을 표현하는 데 diffusion이 효과적이다. - Data Diversity: 하나의 dataset보다 다양한 robot data를 함께 학습할수록 성능이 높아졌다.
- Architecture: 대규모 heterogeneous data에서는 shallow visual tokenizer + Transformer 중심 구조가 더 효과적이었다.
5. Limitations
- 제한적인 Zero-shot Skill Generalization: 새로운 object에는 잘 대응하지만, 새로운 physical skill의 zero-shot 성능은 낮다.
- 데이터 구성 의존: 25개 dataset을 사용하지만 공통 action representation에 맞는 데이터를 선별하고 sampling weight를 조정한다.
- 짧은 Temporal Context: 2-frame observation history만 사용해 장기 상태, 실패 이력, recovery를 직접 유지하기 어렵다.
- 평가 범위 한계: 실제 robot 실험 규모가 크지 않고 safety, OOD detection, failure recovery 등은 주요 평가 대상이 아니다.
RT-X → Octo
| 항목 |
RT-1-X | Octo |
| 핵심 목표 | 여러 Robot 데이터를 하나의 Policy로 통합 | Pretrained Policy를 새로운 Robot에 재사용 |
| Training Data | OXE ~350K Episodes | OXE ~800K Trajectories |
| Task Condition | Language | Language / Goal Image |
| Input / Output | 비교적 고정 | Modular Token Interface |
| Action | Discretized | Continuous Action Chunk |
| Generation | Autoregressive | Diffusion |
| Adaptation | 제한적 | New Sensor / Action Space Fine-tuning |
| 핵심 변화 | Cross-Embodiment Learning | Reusable Generalist Policy Initialization |
RT-X → Octo: RT-X가 여러 로봇의 데이터를 함께 학습하면 서로 도움이 된다는 것을 보여줬다면, Octo는 그 경험을 새로운 robot·sensor·action space에 빠르게 fine-tuning할 수 있는 pretrained policy로 확장했다.


